
一、计算机网络
基础部分
TCP报头格式
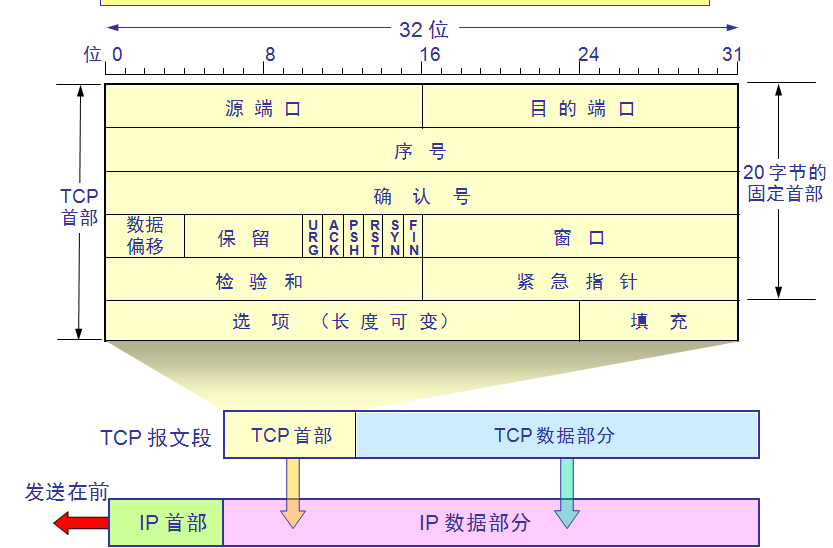
端口号用来标识不同的应用程序。
源端口:标识来源应用程序的
目标端口:标识接收的计算机的应用程序
保留:为将来定义新的用途保留,现在一般置0。
:是本报文段发送的数据组的第一个字节的序号 。每个字节一个序号。比如一个报文段是300.数据大小是100字节。那么下一个报文的序号就是400.所以序号确保了TCP传输的有序性
ack确认号:指明下一个期待收到的字节序号,表明该序号之前的所有数据已经正确无误的收到。确认号只有当ACK标志为1时才有效
数据偏移/首部长度:4bits。由于首部可能含有可选项内容,因此TCP报头的长度是不确定的,报头不包含任何任选字段则长度为20字节,4位首部长度字段所能表示的最大值为1111,转化为10进制为15,15*32/8 = 60,故报头最大长度为60字节。首部长度也叫数据偏移,是因为首部长度实际上指示了数据区在报文段中的起始偏移值。
保留:为将来定义新的用途保留,现在一般置0。
控制位:URG ACK PSH RST SYN FIN,共6个,每一个标志位表示一个控制功能。
ACK 确认序号
SYN同步序号。握手的时候用
FIN 关闭连接
窗口:滑动窗口大小,用来告知发送端接受端的缓存大小,以此控制发送端发送数据的速率,从而达到流量控制。窗口大小时一个16bit字段,因而窗口大小最大为65535。
校验和:奇偶校验,此校验和是对整个的 TCP 报文段,包括 TCP 头部和 TCP 数据,以 16 位字进行计算所得。由发送端计算和存储,并由接收端进行验证。
紧急指针:只有当 URG 标志置 1 时紧急指针才有效。紧急指针是一个正的偏移量,和顺序号字段中的值相加表示紧急数据最后一个字节的序号。 TCP 的紧急方式是发送端向另一端发送紧急数据的一种方式。
选项和填充:最常见的可选字段是最长报文大小,又称为MSS(Maximum Segment Size),每个连接方通常都在通信的第一个报文段(为建立连接而设置SYN标志为1的那个段)中指明这个选项
数据部分: TCP 报文段中的数据部分是可选的。在一个连接建立和一个连接终止时,双方交换的报文段仅有 TCP 首部
TCP报头中的源端口号和目的端口号同IP数据报中的源IP与目的IP唯一确定一条TCP连接。
UDP报头格式

- 1、源端口号,16bit
- 2、目的端口号:数据接收者的端口号,16bit
- 3、UDP长度:UDP长度字段指的是UDP首部和UDP数据的字节长度。该字段的最小值为8字节
- 4、UPD校验和:UDP检验和覆盖UDP首部和UDP数据
- 5、首部长度:首部中32bit字的数目,可表示15*32bit=60字节的首部。一般首部长度为20字节。
- 6、数据
TCP/UDP区别(不仅是宏观上的,最好能根据各自的机制讲解清楚)
TCP存在三次握手。能进行流量控制,保证数据的完整。
UDP不存在握手。会导致丢包。传输比较快。
HTTP状态码(最好结合使用场景,比如在缓存命中时使用哪个)
2xx 标识正常
3xx 标识重定向 比如301 永久重定向 304 标识使用缓存
4xx 标识资源未找到 404 文件没找到 403 禁止访问
5xx 服务器内部错误
HTTP协议(一些报头字段的作用,如cace-control、keep-alive)
OSI协议、TCP/IP协议以及每层对应的协议。
SESSION机制、cookie机制
TCP三次握手、四次挥手(这个问题真的要回答吐了,不过真的是面试官最喜欢问的,建议每天手撸一遍,而且不只是每次请求的过程,各种FIN_WAIT、TIME_WAIT状态也要掌握)。
三次握手
- 客户端将标志位置SYN置1,发送序号为K的数据。客户端进入SYN_SEND状态
- 服务端收到数据包后,先确认这个数据[ack=K+1],将自己的标志位SYN置1,发送序号为M的数据。服务端进入SYN_RECV
- 客户端收到后。将自己标志位置SYN置1.确认序号为M的数据。[ack=M+1]. ESTABLISHED
四次挥手
- 客户端发送将自己的标识FIN置1.发送序号为M的数据包 客户端进入FIN_WAIT_1
- 服务器收到M,先确认ack=M+1。发送ack
- 服务器再发送FIN,序号为N的数据包 进入LAST_ACK
- 客户端收到后,进入TIME_WAIT,再发送ACK=1.ack=N+1的数据包 服务端进入 CLOSED
打开网页到页面显示之间的过(涵盖了各个方面,DNS解析过程,Nginx请求转发、连接建立和保持过程、浏览器内容渲染过程,考虑的越详细越好)。
http和https区别,https在请求时额外的过程,https是如何保证数据安全的
IP地址子网划分
POST和GET区别
DNS解析过程
深入部分
- TCP如何保证数据的可靠传输的(这个问题可以引申出很多子问题,拥塞控制慢开始、拥塞避免、快重传、滑动窗口协议、停止等待协议、超时重传机制,最好都能掌握)
- 地址解析协议ARP
- 交换机和路由器的区别
二、数据库
基础部分
事务四大特性(ACID)
原子性、一致性、隔离性、持久性
数据库隔离级别,每个级别会引发什么问题,mysql默认是哪个级
未提交读 会产生脏读
提交读:
重复读:
序列化
默认是重复读。
MYSQL的两种存储引擎区别(事务、锁级别等等),各自的适用场景
数据库的优化(从sql语句优化和索引两个部分回答)
索引有B+索引和hash索引,各自的区别
B+索引数据结构,和B树的区别
索引的分类(主键索引、唯一索引),最左前缀原则,哪些情况索引会失效
聚集索引和非聚集索引区别。
有哪些锁(乐观锁悲观锁),select时怎么加排它锁
select * from for update; 排它锁
select * from user lock in share mode 共享锁
关系型数据库和非关系型数据库区别
了解nosql
数据库三范式,根据某个场景设计数据表(可以通过手绘ER图)
数据库的主从复制
使用explain优化sql和索引
long_query怎么解决
内连接、外连接、交叉连接、笛卡儿积等
深入
- MVCC机制
- 根据具体场景,说明版本控制机制
- 死锁怎么解决
- varchar和char的使用场景。
- mysql并发情况下怎么解决(通过事务、隔离级别、锁)
Redis
- redis数据结构有哪些
- redis队列应用场景
- redis和Memcached(支持数据持久化)
- 分布式使用场景(储存session等)
- 发布/订阅使用场景
三、操作系统
- 内存的页面置换算法
- 进程调度算法
- 进程间通信方式
- 进程线程区别
- 进程之间的通信
- 父子进程、孤儿进程
- fork进程时的操作,
四、算法
基础
二叉树相关(层次遍历、求深度、求两个节点距离、翻转二叉树、前中后序遍历)
链表相关(插入节点、链表逆置、使用链表进行大数字的加减,双向链表实现队列、寻找链表中的环)
堆(大量数据中寻找最大N个数字几乎每次都会问,还有堆在插入时进行的调整)
排序(八大排序,各自的时间复杂度、排序算法的稳定性。快排几乎每次都问)
二分查找(一般会深入,如寻找数组总和为K的两个数字)
两个栈实现队列。
图(深度广度优先遍历、单源最短路径、最小生成树)
动态规划问题。
深入
红黑树性质
分治法和动态规划的区别
计算时间复杂度
二叉树和哈希表查找的时间复杂度
具体题目
一个文本文件中每一行中有一个URL,最多一万行,统计每一个URL的次数,输出到另外一个文件中,每一行前面是URL,后面是个数。
单链表的逆序
利用栈 遍历链表。每次压栈。然后每次再出栈。
一个函数实现给定字符串,去除前面和后面的空格,比如“ ab cd ”,最后得到的结果是”ab cd”,不能改变字符串的地址。
对比cookie和session,有一个值错误则不正确
查找10的阶乘后面有几个0
字符串匹配
字符串移位,给出字符串abc##dfg##gh,实现将所有#移至字符串串头。输出####abcdfggh(个人认为可以用后向移位,减少移位次数)
给出一颗二叉树,两个叶节点,找到这两个叶节点互连通的一条最短路径。
两个日期计算天数差
100个有序数组合并
矩阵的最大子矩阵和
给定一棵多叉树,每个节点有一个编号,现在要对节点排序,要求对于每个节点,它的父节点排在它后面,如果一棵树有N个节点,那么肯定有N-1条边。输入的数据形式为:Map.Entry
LINUX
- 硬链接和软连接区别
- kill用法,某个进程杀不掉的原因(进入内核态,忽略kill信号)
- linux用过的命令
- 系统管理命令(如查看内存使用、网络情况)
- 管道的使用 |
- grep的使用,一定要掌握,每次都会问在文件中查找
- shell脚本
- find命令
- awk使用
语言部分(PHP)
- 数组操作函数
- 字符串操作函数(数组和字符串的函数是最常问的,非常多,一定不要记混了)
- 指针和引用区别
- 堆和栈的区别
- == ===区别
- PHP的垃圾回收机制
- zval结构
- 防sql注入
- 跨域问题
- 长链接和长轮询
面向对象、设计模式
- 接口和抽象类区别
- 单继承
- construct的调用顺序(子类父类之间)
- 设计模式(工厂模式、策略模式、单例模式、装饰模式比较常见)
- OOP特性,通过哪些机制实现的
- 重写和重载区别
- 静态类静态方法
- 根据某个需求设计一个类(主要考虑类之间的继承关系和属性的权限设置)
项目
- 项目中遇到的困难(提前想好,并且把实现或者优化方法说清楚)
- 系统的量级、pv、uv等
- 应对高并发的解决办法(分布式)
- 在项目中主要负责了哪些工作。
- nginx的负载均衡
- 分布式缓存的一致性,服务器如何扩容(哈希环)
- 项目中用到了哪些技术
- 服务器性能如何测试
- 项目中印象深刻的东西
- 项目中遇到过哪些坑,怎么解决的
- 项目中为什么用redis以及怎么实现相关功能
- 用过的开源框架(路由问题),框架的原理
- 消息队列的应用场景(想一个)
- 有没有用到非关系型数据库
- 网站负载变大时怎么办
- SOA?
- WebService?
- 《大型网站技术架构:核心原理与案例分析》
- redis的消息队列 redis的数据类型
- OAuth认证过程
- 单点登陆系统 分布式缓存的使用场景
- 一个Controller调用两个Service,这两Service又都分别调用两个Dao,问其中用到了几个数据库连接池的连接?
- 图片是怎么存储的
- 分布式一致性协议、分布式锁(应用场景)
- 项目中的网络编程
- 划一下项目的架构
- MVC的路由机制怎么实现的(路由很重要)
- 为什么要用hadoop
- 自己写的接口如何防止被别人恶意调用?印象笔记
- 如何实现数据容灾,
- 怎样实现负载均衡
- 如何解决单节点负载过
- Redis和memcache区别
- redis的持久化